こんにちは。今回は、自然言語処理の現場で広く使われている強力なPythonライブラリ「sentence-transformers」についてご紹介します。
検索機能を作るとき、単語の一致だけでなく「文の意味の近さ」を判定したい場面は多いですよね。sentence-transformersを活用すれば、わずか数行のコードで文章をベクトル化(埋め込み)し、高精度な意味検索や類似度計算を簡単に実現できます。
sentence-transformersの概要
sentence-transformersは、Sentence-BERT(SBERT)をはじめとする最先端の埋め込みモデルを簡単に扱えるライブラリです。
従来のBERTでは2つの文の類似度を計算する際にペア単位で推論する必要があり、大規模なデータセットに対する検索には膨大な時間がかかっていました。SBERTは文章を意味空間上の固定長ベクトルに変換するため、事前にベクトルを計算・保存しておけば、コサイン類似度などを用いてミリ秒単位の高速な検索・比較が可能になります。
「単語が一致していなくても意味が通じる」検索を作りたいときに、まさに必須級のライブラリなんですよ。
sentence-transformersを利用するメリット
- 極めてシンプルなAPI
Hugging FaceのTransformersをベースにしながらも、数行のコードでモデルの読み込みからテキストのベクトル化まで完了します。 - 高速なセマンティック検索
文章を独立してベクトル化できるため、あらかじめデータベース等に保存しておけば、大量の文章から意味的に最も近いものを瞬時に検索できます。 - 豊富な事前学習済みモデル
多言語対応モデル(例:paraphrase-multilingual-mpnet-base-v2)や日本語特化モデルが多数公開されており、用途に合わせて柔軟に選択できます。
サンプルコード:文章の類似度計算と検索
まずはライブラリをインストールします。
pip install sentence-transformers次に、日本語の文章同士のコサイン類似度を計算し、最も類似している文章を検索するサンプルコードを見てみましょう。
from sentence_transformers import SentenceTransformer, util

# 1. 多言語対応モデルのロード
model = SentenceTransformer('paraphrase-multilingual-mpnet-base-v2')

# 2. 検索対象となる文章群(コーパス)
corpus = [
    "今日はとても天気が良くて気持ちがいいです。",
    "美味しいコーヒーを淹れて一息つきました。",
    "Pythonを使った機械学習の勉強を進めています。",
    "快晴の青空が広がり、心地よい風が吹いています。"
]

# 3. 検索クエリ
query = "抜けるような青空で散歩日和ですね。"

# 4. 文章をベクトル(埋め込み)に変換
corpus_embeddings = model.encode(corpus, convert_to_tensor=True)
query_embedding = model.encode(query, convert_to_tensor=True)

# 5. コサイン類似度の計算
cosine_scores = util.cos_sim(query_embedding, corpus_embeddings)[0]

# 6. 結果の表示
print(f"検索クエリ: {query}\n")
results = sorted(zip(corpus, cosine_scores), key=lambda x: x[1], reverse=True)
for text, score in results:
    print(f"類似度: {score:.4f} | 文章: {text}")
util.cos_sim() を使うと、PyTorchテンソル同士のコサイン類似度を一瞬で行列計算してくれるのでとても便利です。
実行すると、単語が直接一致していなくても、「青空」や「天気」といった意味的な共通点から、1番目と4番目の文章が高い類似度として判定されることが確認できます。
検索クエリ: 抜けるような青空で散歩日和ですね。

類似度: 0.8207 | 文章: 快晴の青空が広がり、心地よい風が吹いています。
類似度: 0.5938 | 文章: 今日はとても天気が良くて気持ちがいいです。
類似度: 0.2948 | 文章: 美味しいコーヒーを淹れて一息つきました。
類似度: 0.0596 | 文章: Pythonを使った機械学習の勉強を進めています。
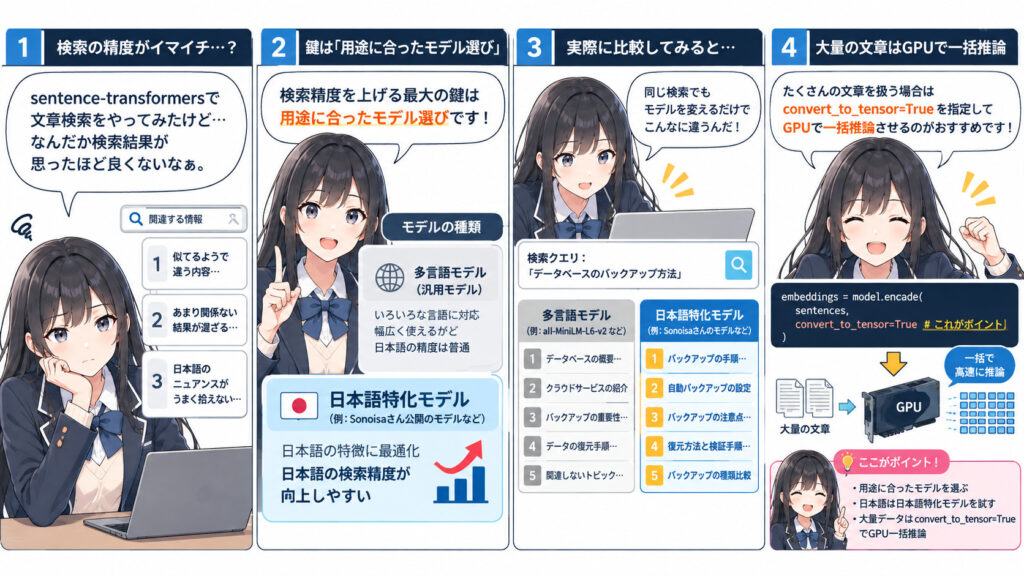
みーちゃんのワンポイント
sentence-transformersで高精度な検索を実現する最大の鍵は「用途に合ったモデル選び」です。日本語を扱う際は、多言語モデルだけでなく、Hugging Face上で公開されている日本語特化のモデル(例えばSonoisaさん公開のモデルなど)を試すことで、精度の向上が期待できます。また、大量の文章を扱う場合は convert_to_tensor=True を指定し、GPUで一括推論させることを忘れないようにしてくださいね。