深層学習(ディープラーニング)の世界に足を踏み入れると、必ず耳にするのが「PyTorch(ライブラリ名:torch)」です。研究現場から産業界まで幅広く支持されているこのライブラリは、Pythonらしい直感的な記述と柔軟な設計が魅力です。今回は、基礎概念からテンソル操作、簡単な自動微分の実践までを分かりやすく解説します。
torchの概要
torchは、Meta(旧Facebook)のAI研究チームを中心に開発されているオープンソースの機械学習ライブラリです。多次元配列を扱う「テンソル(Tensor)」の高速な演算機能と、ニューラルネットワークの学習に不可欠な「自動微分機能(Autograd)」を提供しています。NumPyと親和性の高いインターフェースを持ちながら、GPUを活用した大規模な並列計算が簡単に行える点が大きな特徴です。
NumPyを扱ったことがある方なら、ほとんど違和感なく書き始めることができますよ。
torchの主なメリット
- 直感的でPythonicな記法
NumPyと非常によく似た操作感で配列演算が可能です。Pythonの制御構文(if文やfor文)をそのまま計算グラフに組み込める動的計算グラフ(Define-by-Run)を採用しているため、デバッグがしやすいのも強みです。 - シームレスなGPUアクセラレーション
作成したテンソルやニューラルネットワークのモデルを、.to('cuda')の一言で手軽にGPUメモリへ転送し、高速に演算させることができます。 - 豊富なエコシステムと圧倒的なシェア
学術論文の実装コードの多くがPyTorchで公開されており、最先端のモデル(LLMや画像生成AIなど)を扱うライブラリ(Hugging FaceのTransformersなど)の基盤としてもデファクトスタンダードとなっています。
サンプルコード:テンソル操作と自動微分の基本
まずは、torchの基本であるテンソル作成と自動微分を体験してみましょう。
pip install torchimport torch
# 1. テンソルの作成
# requires_grad=True にすることで、このテンソルに関する勾配を自動追跡します
x = torch.tensor([2.0, 3.0], requires_grad=True)
print(f"入力 x: {x}")
# 2. 計算の定義 (y = x^2 + 3x + 1)
y = x**2 + 3*x + 1
print(f"計算結果 y: {y}")
# 3. スカラー化して勾配を計算 (y の合計に対して逆伝播)
# loss = sum(y) = (x1^2 + 3x1 + 1) + (x2^2 + 3x2 + 1)
loss = y.sum()
loss.backward()
# 4. 勾配 (d(loss)/dx = 2x + 3) の確認
# x = [2.0, 3.0] なので、勾配は [2*2+3, 2*3+3] = [7.0, 9.0] になります
print(f"x の勾配 (x.grad): {x.grad}")
# 5. GPUが利用可能かチェックしてテンソルをGPUへ送る例
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
x_gpu = x.to(device)
print(f"配置先デバイス: {x_gpu.device}")backward()を呼ぶだけで偏微分の値が求まるのは、何度見ても感動しますね。
入力 x: tensor([2., 3.], requires_grad=True)
計算結果 y: tensor([11., 19.], grad_fn=<AddBackward0>)
x の勾配 (x.grad): tensor([7., 9.])
配置先デバイス: cpu
みーちゃんのワンポイント
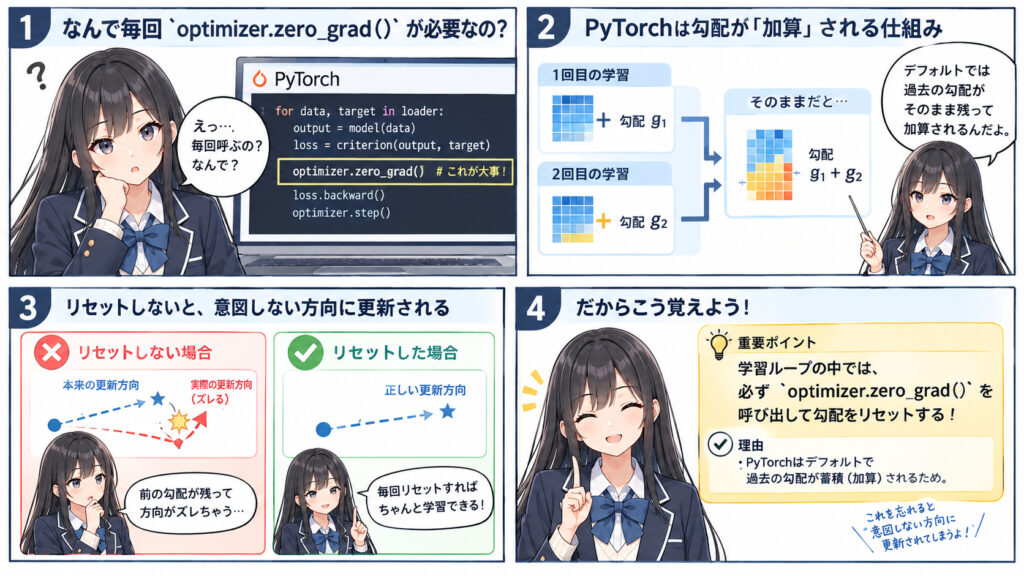
学習ループ内では、更新前に必ず optimizer.zero_grad() を呼び出して勾配をリセットしましょう。PyTorchではデフォルトで過去の勾配が蓄積(加算)される仕様になっているため、リセットを忘れると意図しない方向へパラメータが更新されてしまいます。