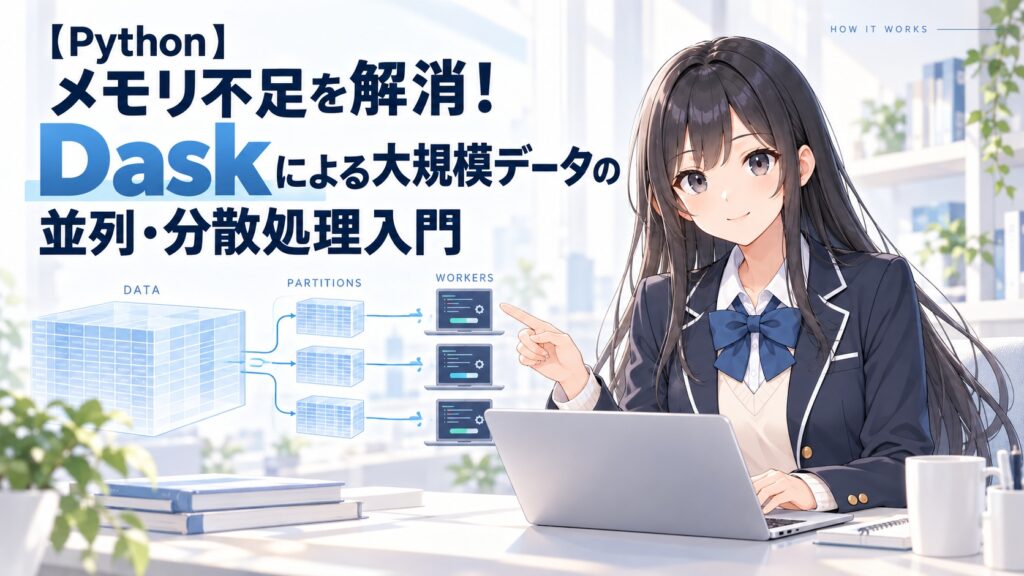
普段のデータ分析で、Pandasを使っていて「メモリ不足(OutOfMemoryError)」に悩まされた経験はありませんか?PCのスペックを超えるような巨大なCSVファイルやデータセットを前に、途方に暮れてしまうこともあるかもしれません。
そんなときに頼りになるのが、今回ご紹介する「Dask」です。使い慣れたPandasやNumPyとほぼ同じインターフェースのまま、マルチコアCPUのパワーを引き出して並列処理を行い、メモリに収まらない巨大なデータを効率的に扱うことができます。
Daskの概要
Daskは、Pythonにおける並列コンピューティングを柔軟に実現するためのオープンソースライブラリです。PandasのDataFrameやNumPyのndarrayを小さな「チャンク(塊)」に分割し、タスクグラフ(処理の手順書)を構築して効率的にスケジュール・実行します。
必要になるまで実際の計算を行わない「遅延評価(Lazy Evaluation)」を採用しているため、限られたメモリリソースでもギガバイト級・テラバイト級のデータを安定して処理できるのが特徴です。
Pandasで書いたコードのインポート文を差し替えるだけで動くことも多いので、学習コストがとても低いのが嬉しいポイントですね。
Daskを導入するメリット
- Pandasライクな操作性:
dask.dataframeはPandasと酷似したAPIを持っているため、既存のコード資産や知識をそのまま活かせます。 - メモリ効率の最大化: データを小分けにして順次読み込み・計算を行うため、物理メモリの容量を超えるデータサイズでもクラッシュせずに処理可能です。
- ローカルから分散クラスタまで対応: 自分のノートPCのマルチコアを活用した並列処理はもちろん、クラウド上のクラスタ環境へのスケールアウトもシームレスに行えます。
サンプルコード
ここでは、大容量のCSVデータを読み込んで集計を行う基本的な使い方をご紹介します。Pandasと非常によく似ている点に注目してください。
pip install "dask[dataframe]" pandasimport dask.dataframe as dd
# 大規模なCSVファイルを読み込み(チャンクに分割して遅延読み込み)
# ワイルドカード(*.csv)を使った複数ファイルの一括読み込みも可能です
df = dd.read_csv("large_dataset_*.csv")
# フィルタリングとグループごとの集計処理を定義
# この段階ではまだ実際の計算は実行されず、処理手順(グラフ)が作られます
filtered_df = df[df["status"] == "completed"]
result_graph = filtered_df.groupby("category")["amount"].mean()
# compute() を呼び出すことで、並列計算が実行されて結果がPandasのオブジェクトとして返されます
final_result = result_graph.compute()
print("カテゴリ別平均金額:")
print(final_result)カテゴリ別平均金額:
category
books 2274.941515
clothing 4627.012403
electronics 41084.000383
groceries 2998.855486
home 15810.032353
Name: amount, dtype: float64みーちゃんのワンポイント
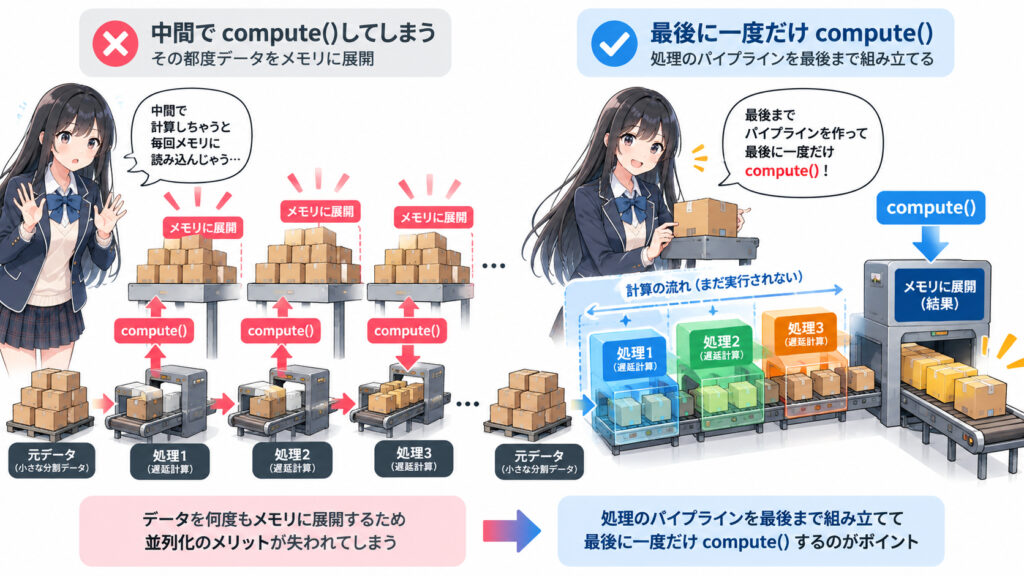
Daskを使う上で最も大切なのは、compute()を呼ぶタイミングです。中間処理のたびにcompute()を実行してしまうと、その都度データをメモリに展開して並列化のメリットが失われてしまうため、処理のパイプラインを最後まで組み立ててから最後に一度だけ呼び出すようにしましょう。